계속해서 등장하는 이미지 모델을 평가하고 적용하면서
Seedream, GPT Image, Nano Banana, Ideogram을 보며 정리한 기준
2026년 11월 4일에 OpenAI가 GPT-Image-2.6을 냈다. 그리고 닷새 뒤 ByteDance가 Seedream 5.5를 발표했다. Google의 Nano Banana 2.1은 그보다 한 달 앞서 나왔다.
OpenAI 쪽만 따로 세어 봤다. 4월에 gpt-image-2, 9월에 2.5, 11월에 2.6(changelog). 일곱 달 동안 세 번이다. 비교 결과를 정리하고 나면 그새 새 모델이 또 나와 있다. 이 글을 준비하는 동안에도 Seedream 5.5가 나오고 열흘 뒤 Ideogram 4.6이 나왔다.
이미지 생성 모델을 제품에 붙여 쓰고 있다면 새 모델이 나올 때마다 고민이 된다. 이번 거 좋다던데, 우리도 바꿔야 하나?
이 질문에 답을 정해 둬도 오래 쓰지는 못한다. 지난달에 제일 나았던 모델이 이번 달에도 제일 낫다는 보장이 없다. 그래도 모델이 바뀐다고 같이 바뀌지 않는 것도 있다. (Virtual Try On 관점에서) 옷 색이 원본과 달라지면 안 되고, 로고가 뭉개지면 안 된다. 이런 조건을 미리 적어 두고 확인할 방법까지 만들어 두면, 새 모델이 나왔을 때 그것부터 돌려 보면 된다.
1편에서는 AI를 어떻게 쓸지에 대해 썼다. 이번 글은 그다음 이야기로, 쓸 수 있는 모델이 이렇게 많을 때 무엇을 골라야 하는지 적어 보려 한다.
생성 모델과 편집 모델, 따로 있는 걸까
GPT-Image-2.6, Seedream 5.5, Nano Banana를 흔히 “이미지 편집 모델”이라고 부르지만, 이 모델들은 텍스트만 넣어도 그림을 만든다. 그럼 생성 모델과 편집 모델은 뭐가 다를까. 아무거나 써도 되는 것 아닐까.
몇 년 전까지는 둘이 실제로 따로 있었다. 텍스트로 그림을 만드는 모델이 있었고, 그 위에 지시문으로 사진을 고치는 모델(InstructPix2Pix 같은)이나 지정한 영역만 다시 칠하는 inpainting 모델을 따로 붙였다. ByteDance도 생성은 Seedream, 편집은 SeedEdit으로 나눠 두었고, Alibaba도 Qwen-Image와 Qwen-Image-Edit을 따로 내놨다가 Qwen-Image-2.0에서 하나로 합쳤다.
지금은 대부분 한 모델이 둘 다 한다. OpenAI는 GPT-Image-2.6을 생성과 편집 모두를 위한 모델로 내놨고, API만 generations와 edits로 나뉘어 있다. Seedream은 4.0에서 생성과 편집을 한 모델로 합쳤고, FLUX.2도 하나의 모델로 둘 다 한다. 차이는 입력에 있다. 텍스트만 주면 생성이고, 이미지를 같이 주면 편집이다.
둘 다 써도 되느냐고 물으면, 된다. 다만 task가 대신 정해 주는 경우가 많다. 텍스트만으로는 세상에 하나뿐인 우리 상품을 그릴 수 없다. 실제 상품이 나와야 하면 상품 사진을 넣어야 하고, 그 순간 편집이 된다. 그래서 작업을 원본에서 무엇을 지켜야 하는지로 나눠 보면 정리가 쉽다.
| 지켜야 하는 것 | 예 | 주는 입력 |
|---|---|---|
| 없음 | 캠페인 무드 시안, 배경 아이디어 | 텍스트 |
| 대상의 정체 (같은 상품, 같은 사람) | 상품 사진으로 새 배경의 컷 만들기, 착용 컷 | 텍스트 + 참조 이미지 |
| 원본의 픽셀 (고친 곳 말고는 전부) | 로고 위치 수정, 얼룩 지우기 | 텍스트 + 원본 이미지 (+ 영역 지정) |
아래로 내려갈수록 모델이 “새로 그릴 자유”가 줄어든다. 가운데 줄은 API로 보면 편집이지만 하는 일은 새 장면을 만드는 생성에 가깝다. 같은 edits 엔드포인트를 불러도 어느 줄의 작업이냐에 따라 기대하는 결과와 평가 기준이 달라진다. 패션 커머스에서 쓰는 이미지는 대부분 아래 두 줄에 있다. 이 글에서 계속 이야기할 “편집”도 이 두 줄을 말한다.
모델마다 출발점이 다르다
Seedream, FLUX, Qwen-Image는 이미지 전용 diffusion 계열에서 출발했다. 반대로 GPT Image와 Nano Banana는 언어 모델이 이미지를 직접 내놓는 쪽이다. OpenAI는 GPT-4o 이미지 생성을 처음 공개할 때 DALL·E와 달리 ChatGPT 안에 들어간 autoregressive 모델이라고 설명했고, Google도 Gemini 3 기반 이미지 모델을 모델 카드에서 natively multimodal 모델로 소개한다.
Ideogram은 또 다른 데서 왔다. Google의 이미지 생성 모델 Imagen 논문을 쓴 연구자 네 명이 세운 회사로, 그림 속 글자를 읽을 수 있게 쓰는 생성 모델로 이름을 알렸다. 4.0은 가중치를 Apache 2.0으로 공개했고, 4.5부터는 편집을 앞세우고 있다. 글자에서 출발해 편집으로 넘어온 셈이다.
다만 요즘은 이렇게 나누기도 애매하다. Seedream 5.0은 통합 멀티모달 구조를 내세웠고, FLUX 3는 이미지와 영상, 오디오를 한 모델에 담았다. OpenAI와 Google은 최신 모델 내부를 거의 공개하지 않아서 정확히 어떻게 만들어졌는지는 바깥에서 알 수 없다.
쓰는 방법도 제각각이다. 이미지의 어느 부분을 고칠지 알려 주는 방식만 봐도 그렇다. GPT Image는 mask를 받고, 2.5부터는 그림 위에 동그라미나 화살표를 그려서 지시할 수도 있다. FLUX 3와 Seedream 5.x는 좌표로 영역을 받는데, 둘 다 0~1000 범위를 쓰면서 좌표 순서는 또 다르다. Ideogram은 mask를 받고, 고칠 범위를 픽셀 좌표로 따로 줄 수도 있다.
모델은 원본을 보고 다시 그린다
구조가 공개된 편집 모델들(FLUX.1 Kontext, Qwen-Image-Edit)을 보면 결과 이미지를 노이즈에서부터 통째로 새로 그린다. 원본 이미지는 “이걸 보고 그려라”라는 참고 자료로 들어갈 뿐이다.
원본 이미지 ──▶ 참고 자료 ─┐
                          ├─▶ 결과 이미지를 처음부터 새로 그림
편집 지시   ──▶ 의미 정보 ─┘
편집이라고 하면 보통 고칠 부분만 손대고 나머지는 그대로 두는 걸 떠올린다. 그런데 모델 입장에서는 고치지 않는 부분도 매번 다시 그린다. 그대로 남아 보이는 건 모델이 그만큼 원본을 잘 베껴 그렸기 때문이다. OpenAI 문서에도 mask는 참고용이라 정확한 모양을 따르지 않을 수 있다고 적혀 있다.
그래서 편집을 잘하는지 볼 때는 시킨 걸 잘 바꾸는지와 시키지 않은 걸 잘 남기는지를 따로 봐야 한다. 많이 바꾸게 할수록 원본에서 멀어지기 쉬워서, 둘을 한꺼번에 끌어올리기는 어렵다. ByteDance의 첫 편집 모델 논문도 제목부터 이 균형을 다룬다. 어느 쪽에 더 무게를 두는지는 모델마다 다르다.
Ideogram은 남기는 쪽을 다른 방식으로 푼다. 편집 정밀도를 높이고 mask를 주면 mask 바깥은 원본 픽셀로 되돌려 준다고 문서에 적혀 있다. 모델이 원본을 잘 베껴 그리길 기대하는 대신, 고치지 않은 곳은 원본으로 덮어 버리는 방식이다. 문서대로라면 mask 바깥은 몇 번을 고쳐도 무너질 일이 없다. 대신 확인할 곳이 고친 곳과 원본이 만나는 경계로 옮겨 간다.
여러 번 고치면 얼마나 무너질까
같은 이미지를 여러 번 고쳐 보면 Seedream 5.5는 원본이 꽤 잘 유지되는데, GPT-Image-2.6은 고칠수록 질감이 뭉개졌다. 이 차이가 궁금해서 이 글을 쓰기 시작했다.
느낌만으로는 글을 쓸 수 없어서 근거부터 찾아봤다. ByteDance는 Seedream 5.5 발표문에서 편집하지 않은 영역을 픽셀 수준으로 지키고 색이 틀어지지 않게 해서 100번까지 이어서 고칠 수 있다고 했다. 방법은 “targeted training”이라는 한 마디뿐이었다.
한 세대 전 모델로 한 독립 연구는 있었다. EdiVal-Agent는 여러 모델로 같은 이미지를 세 번 연속 고치면서 얼마나 일관되게 유지되는지 쟀다. GPT-Image-1은 턴이 지날수록 일관성이 낮은 편이었고, 배경이 원본과 얼마나 비슷하게 남는지(DINOv3 유사도)는 Seedream 4.0이 95.5 —> 90.5로, GPT-Image-1이 88.7 —> 83.8로 떨어졌다. 5.5와 2.6을 직접 비교한 것도 하나 찾았다. 발표 당일 Alisa Qian이 X에 올린 영상이다. 손목시계 사진에 “시계를 1초 뒤로” 하는 편집을 직전 결과에 100번 이어서 걸었다. offloop의 비교 글이 이 영상의 50번째와 100번째 장면을 정리해 뒀다. 50번째에서 GPT Image 2.5와 2.6은 둘 다 큰 색 얼룩이 생겼고, 100번째에서 2.6은 아예 시계만 크게 찍은 사진이 됐다. Seedream 5.5는 50번째에도 뒤쪽 포장지를 알아볼 수 있었고, 100번째까지 손목과 탁자를 그대로 지켰다.
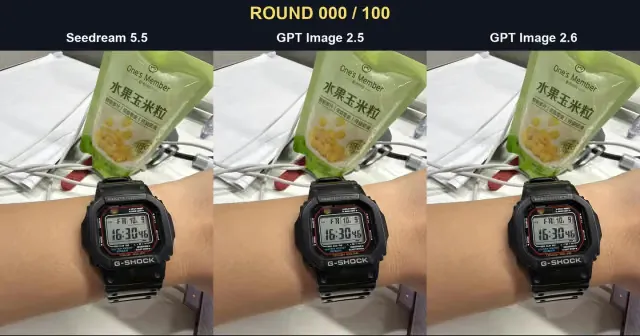
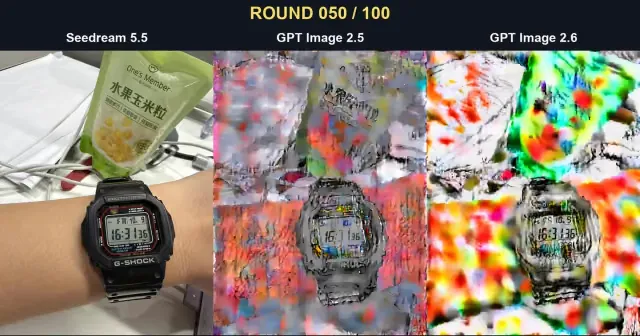
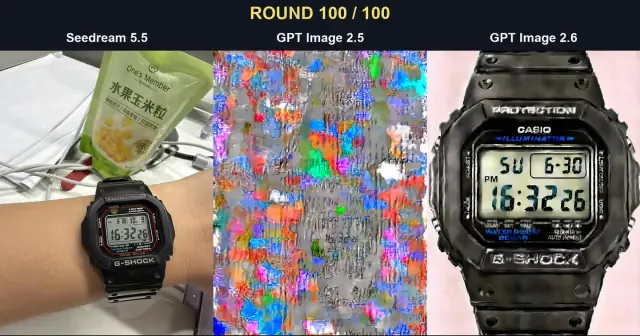
출처: Seedream 5.5 vs GPT Image 2.6 — Image Editing, Generation, and API Pricing
인상적인 결과지만 사진 한 장, 지시 하나로 돌린 테스트다. GPT 쪽이 Sunburst인지 Flare인지, 설정은 어땠는지도 나와 있지 않다. offloop도 같은 글에서 이미지를 9:16으로 늘리는 예시는 GPT-Image-2.6이 주변 장면을 더 많이 살렸다고 적었다.
왜 무너질까?
논문과 공식 문서에서 확인되는 원인만 추려 봤다.
diffusion 계열 모델은 대부분 이미지를 압축된 latent로 바꿔서 작업하고 다시 이미지로 되돌린다. 이 왕복이 완벽하지 않아서, 결과를 다시 입력으로 넣으면 손실이 조금씩 쌓인다(REED-VAE). 편집 모델은 보통 실제 사진으로 학습해서, 자기가 만든 이미지를 다시 받는 상황에는 익숙하지 않다. 그래서 작은 차이가 턴마다 쌓인다는 설명도 있다. 색과 밝기가 턴마다 한쪽으로 흐르는 현상도 EdiVal 연구에 나온다. OpenAI는 GPT-Image-2.6에서 생성 전에 complexity를 높이면 원치 않는 변경이 늘 수 있다고 문서에 적어 뒀다.
재는 방법도 신경 써야 했다. Banana100 연구는 Nano Banana Pro로 100번 반복 편집한 이미지를 모아서, 원본 없이 이미지 품질만 보는 지표 21개로 재 봤다. 그런데 어떤 지표도 무너지는 걸 제대로 잡지 못했다. 반복 편집은 원본과 비교해서 재야 한다는 얘기다.
새 모델이 나오면 어떻게 볼까
새 모델이 나왔을 때 어떻게 볼지는 아래처럼 정리해 봤다.
-
틀리면 안 되는 것부터 적는다. 상품만 찍은 컷에서는 색과 로고, 배경색 규격이 틀리면 안 된다. 착용 컷이면 거기에 모델 얼굴과 체형이 더해진다. 부분 수정은 고친 곳 바깥이 그대로여야 한다. 캠페인 이미지는 상품을 알아볼 수만 있으면 나머지는 분위기 싸움이다. 이렇게 반드시 지켜야 하는 조건은 평균 점수에 섞지 않는다.
-
평가 도구는 새 모델이 나오기 전에 만들어 둔다. 실패가 잘 드러나는 이미지 10~20장, 우리 제품에서 실제로 하는 작업 몇 가지, 모델 이름만 바꾸면 같은 조건으로 돌아가는 스크립트. 요청 파라미터와 모델 버전, 날짜, 걸린 시간, 비용도 전부 남겨 둔다.
-
(중요!!) 점수보다 쓰는 방법이 어떻게 바뀌었는지 본다. 영역을 어떻게 지정하는지, 참조 이미지를 몇 장 받는지, 최대 해상도가 얼마인지, 워터마크가 기본으로 붙는지. 이런 게 바뀌어야 우리 파이프라인에서 실제 결과가 바뀐다. 앞에서 말한 “다시 그린다”는 관점도 여기서 써먹을 수 있다. “편집 품질이 좋아졌다”는 발표를 보면 더 잘 바꾸게 됐다는 건지, 더 잘 남기게 됐다는 건지부터 따져 본다. 우리한테 필요한 쪽이 아니면 급하게 볼 필요가 없다.
고를 때 같이 정해야 하는 것
모델을 고르다 보면 뭘 포기할지도 같이 정하게 된다. 생성 전에 오래 생각하게 하면 결과가 좋아지기도 하지만 느려지고, 앞에서 본 것처럼 원치 않는 변경이 늘 수도 있다. 최신 버전이 오히려 해상도가 낮을 때도 있다. 고친 곳 바깥이 절대 바뀌면 안 된다면 모델이 잘 남겨 주길 기대하기보다 원본 픽셀을 다시 덮어씌우는 쪽이 확실하다. Ideogram처럼 이걸 API에서 해 주는 모델도 있다. 대신 이음새를 신경 써야 한다. 비용도 호출 한 번 가격으로 비교하면 판단이 틀어진다. 싼 모델이라도 다시 돌리고 버리는 횟수가 많으면 쓸 수 있는 결과 한 장 값은 오히려 비싸다.
마치며
이 글이 올라갈 즈음에도 아마 새 모델이 하나쯤 나와 있을 수도 있다. 그 모델도 같은 사진, 같은 편집으로 돌려서 위 표에 한 줄을 더하면 된다.
그런데 이 방식에도 막히는 데가 있다. 평가할 이미지가 수천 장이 되면 사람이 다 볼 수가 없다. 그럼 AI가 만든 이미지를 AI한테 평가시켜도 될까? 다음 글에서 이 질문을 다룬다.
참고 자료
- OpenAI API changelog: https://developers.openai.com/api/docs/changelog
- OpenAI Image generation guide: https://developers.openai.com/api/docs/guides/image-generation
- OpenAI deprecations: https://developers.openai.com/api/docs/deprecations
- OpenAI GPT-4o image generation system card addendum: https://openai.com/index/gpt-4o-image-generation-system-card-addendum/
- ByteDance Seed, Seedream 5.5 발표 (2026-11-09): https://seed.bytedance.com/en/blog/more-realistic-images-more-stable-editing-across-100-rounds-introducing-seedream-5-5
- ByteDance Seed, Seedream 5.0 Lite 발표: https://seed.bytedance.com/en/blog/deeper-thinking-more-accurate-generation-introducing-seedream-5-0-lite
- BytePlus ModelArk 모델 목록: https://docs.byteplus.com/en/docs/modelark/model-list
- Google Nano Banana 2.1: https://ai.google.dev/gemini-api/docs/models/gemini-nano-banana-2.1
- Ideogram API 문서 (모델 목록, Precise Edit): https://developer.ideogram.ai/v2/ideogram-api/models
- Ideogram Precise Edit API (mask, 편집 범위 좌표): https://developer.ideogram.ai/v2/api-reference/images/precise-edit/ideogram-4-5
- fal, Ideogram 4.6 Edit (edit_precision, mask 설명): https://fal.ai/models/ideogram/v4.6/edit/api
- Ideogram (Wikipedia, 창업자·버전 이력): https://en.wikipedia.org/wiki/Ideogram_(text-to-image_model)
- Imagen (2022): https://arxiv.org/abs/2205.11487
- Google Gemini 3 Pro Image 모델 카드: https://storage.googleapis.com/deepmind-media/Model-Cards/Gemini-3-Pro-Image-Model-Card.pdf
- Black Forest Labs, FLUX 3: https://bfl.ai/blog/flux-3
- Black Forest Labs, FLUX.2: https://bfl.ai/blog/flux-2
- InstructPix2Pix (2022): https://arxiv.org/abs/2211.09800
- Qwen-Image-Edit-2509: https://huggingface.co/Qwen/Qwen-Image-Edit-2509
- Qwen-Image (GitHub, Qwen-Image-2.0 공지 포함): https://github.com/QwenLM/Qwen-Image
- SeedEdit (2024): https://arxiv.org/abs/2411.06686
- Seedream 4.0 Technical Report (2025): https://arxiv.org/abs/2509.20427
- FLUX.1 Kontext (2025): https://arxiv.org/abs/2506.15742
- Qwen-Image Technical Report (2025): https://arxiv.org/abs/2508.02324
- EdiVal-Agent (2025): https://arxiv.org/abs/2509.13399
- Alisa Qian, Seedream 5.5 / GPT Image 2.5 / 2.6 시계 100회 연속 편집 영상 (X, 2026-11-09): https://x.com/alisaqqt/status/2119805701300408634
- offloop, Seedream 5.5 vs GPT Image 2.6 (2026-11-13 갱신): https://offloop.org/learn/seedream-5-5-vs-gpt-image-2-6
- REED-VAE (2025): https://arxiv.org/abs/2504.18989
- Banana100 (2026): https://arxiv.org/abs/2604.03400
- Photoroom Product Fidelity Benchmark (2026-07-06, vendor 실험): https://www.photoroom.com/blog/top-editing-image-models-maintain-product-details-only-28-of-the-time
- Arena Image Edit: https://arena.ai/leaderboard/image-edit
- Artificial Analysis Image Editing: https://artificialanalysis.ai/image/leaderboard/editing
서준수의 글쓰기 클럽 2기2 / 2